前言
阅读联邦学习论文时,经常会遇到一句话:使用 Dirichlet 分布划分客户端数据,并用 $\alpha$ 控制 Non-IID 程度。它看起来像一个现成的实验开关,但如果只记住“$\alpha$ 越小,数据越不均匀”,很容易漏掉关键细节。
这个概率向量是在给一个客户端分配不同标签,还是给一个标签分配不同客户端?$\alpha$ 是每个坐标的参数,还是所有坐标参数之和?划分代码有没有顺便改变客户端的数据量?这些问题都会影响实验结果。
这篇从概率分布本身讲起,再给出一个可以直接运行的数据划分例子。这里讨论的是人工构造标签异质性,不是对真实联邦数据的完整建模。
为什么需要模拟 Non-IID?
设客户端 $k$ 的数据来自分布 $P_k(X,Y)$。当不同客户端的分布不一致时,它们优化的本地目标也可能不同:
这里 $\pi_k\ge0$,且 $\sum_k\pi_k=1$;常见选择是按客户端样本量加权。即使所有客户端从同一个模型出发,各自进行多步本地训练之后,更新方向也可能逐渐偏离。
但 Non-IID 不只有一种形式:
| 差异 | 一个直观例子 | 仅按标签划分能否完整模拟? |
|---|---|---|
| 标签分布差异 $P_k(Y)$ | 不同设备上猫与狗的图片比例不同 | 可以构造这一维度的差异 |
| 条件特征分布差异 $P_k(X\mid Y)$ | 同样是狗,不同设备使用不同相机拍摄 | 不能完整模拟 |
| 条件标签机制差异 $P_k(Y\mid X)$ | 不同机构对相似样本采用不同标注规则 | 不能完整模拟 |
| 样本量差异 $n_k$ | 活跃用户与低频用户的数据量不同 | 可能被划分过程同时引入 |
这些描述之间并非完全独立。比如固定各类样本池后改变标签比例,也可能改变客户端的整体特征分布。实验中应说明实际构造了什么,而不是把所有差异压缩成一个 Non-IID 标签。
Hsu 等人的工作使用 Dirichlet 分布生成不同程度的客户端标签分布,研究这种差异对 FedAvg 的影响。它提供了一个有用的实验思路,但参数含义需要结合其具体构造来读。1
Dirichlet 分布是什么?
它生成一个概率向量
一个 $d$ 维 Dirichlet 随机向量满足
其中每个 $\alpha_i>0$。它的输出不是类别编号,也不是整数样本量,而是各个类别或各个客户端所占的比例。
令 $\alpha_0=\sum_i\alpha_i$。在单纯形的内部,其密度为
这里的密度是相对于 $d-1$ 维坐标定义的,因为最后一个分量由前面的分量决定。二维情况下,它退化为 Beta 分布;三维情况下,可以把每次采样画成三角形中的一个点。
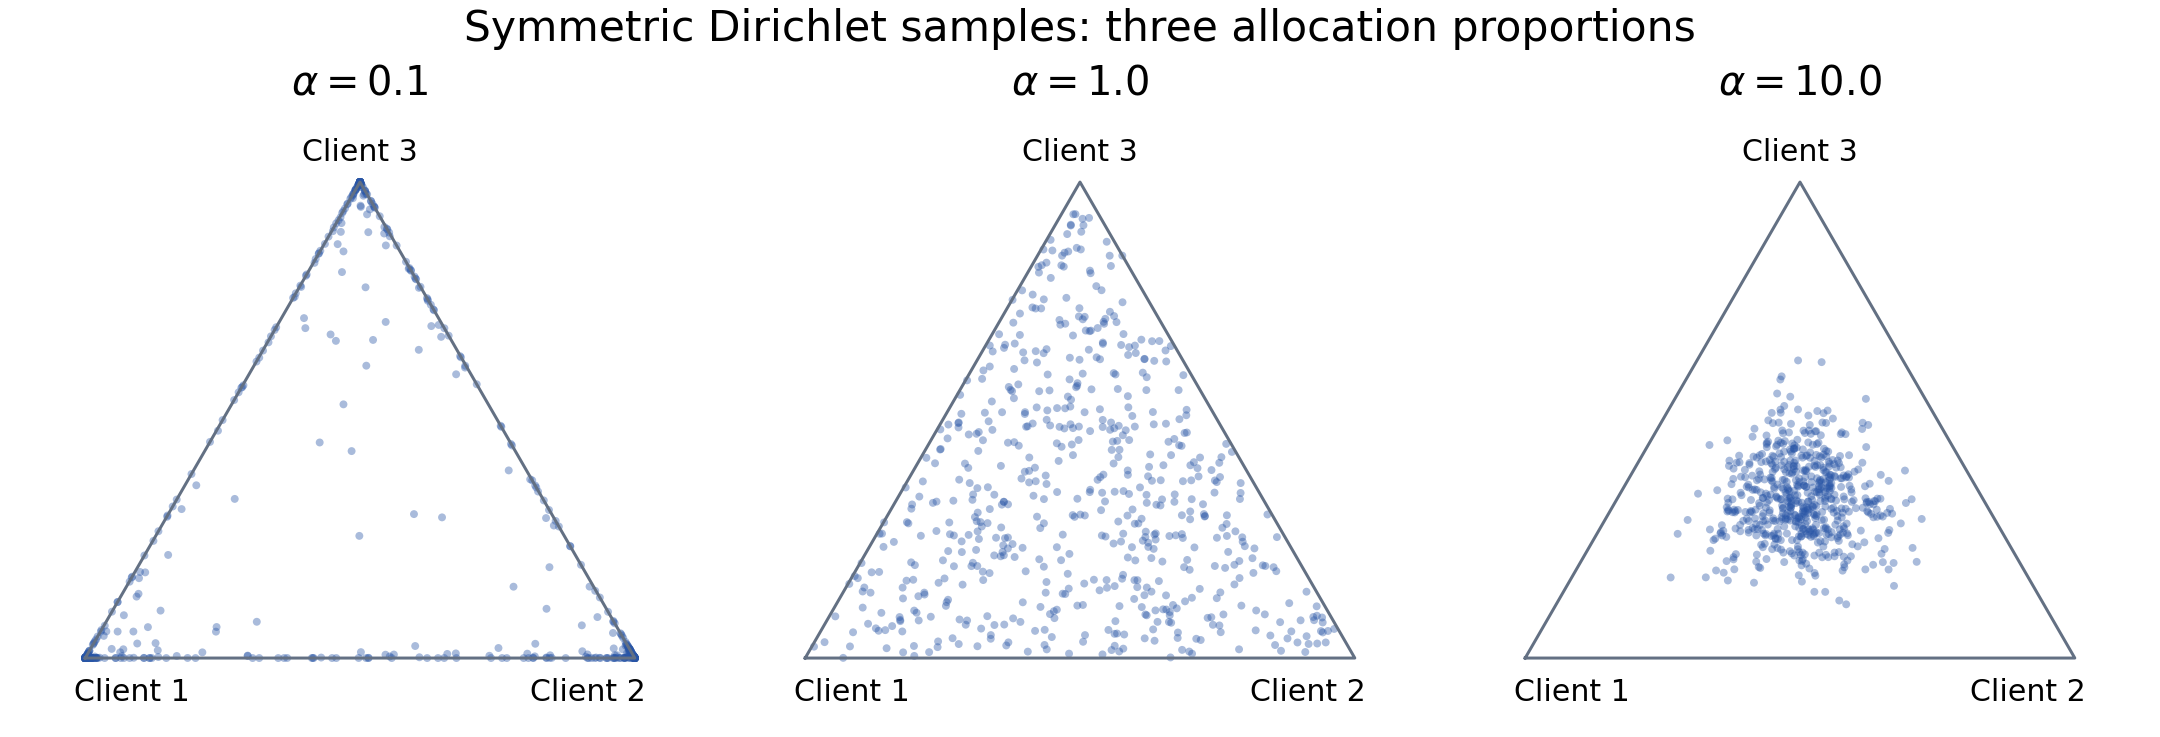
每个点是一组总和为 1 的比例。靠近顶点表示某个分量占主导,靠近中心表示三个分量比较接近。
定义与采样方法可以查阅 Stanford 课程笔记2 和 NumPy 文档3。图中的 $\alpha$ 指每个坐标的参数。
均值与波动是两件事
Dirichlet 分布的均值、方差和不同坐标之间的协方差为
协方差为负并不奇怪:所有比例的总和固定为 1,一个分量变大,其他分量就需要让出空间。
如果使用对称参数 $\alpha_1=\cdots=\alpha_d=\alpha$,则
所以,减小 $\alpha$ 并没有改变每个坐标的平均比例,而是增大了一次采样与平均比例之间的波动。某一次采样可能几乎全给第一个分量,下一次却可能几乎全给第三个分量。
- $\alpha<1$ 时,分布更偏向单纯形的边界,容易出现某些分量很小、某些分量占主导的情况。
- $\alpha=1$ 时,在单纯形上均匀分布,不是每次都输出均匀比例。
- $\alpha>1$ 时,分布更偏向中心;当 $\alpha$ 很大时,比例更加接近 $1/d$。
这是一种分布层面的趋势,不能保证每一次小 $\alpha$ 的采样都比每一次大 $\alpha$ 的采样更偏斜。 而且即使概率向量非常接近均匀,有限样本的整数分配仍然会有波动,不能把“大 $\alpha$”直接等同于每个客户端的经验分布完全一致。
单个坐标参数与总浓度
还可以把参数写成 $\alpha_i=s m_i$,其中 $m_i>0$、$\sum_i m_i=1$,于是
$\mathbf m$ 控制中心位置,$s$ 控制围绕这个中心的波动。均匀中心对应 $m_i=1/d$,这时每个坐标的参数是 $s/d$。
因此,$\operatorname{Dir}(\alpha,\ldots,\alpha)$ 与 $\operatorname{Dir}(\alpha\mathbf m)$ 的参数不能直接对比。前者的总浓度为 $d\alpha$,后者的总浓度为 $\alpha$。Hsu 等人的论文使用后一种写法;复现实验时,应把这一区别写清楚。
在联邦学习中,有两种划分方向
设共有 $K$ 个客户端、$C$ 个类别,类别 $c$ 的样本量为 $N_c$。
方向一:给每个客户端生成类别比例
对每个客户端 $k$,采样一个 $C$ 维向量:
它描述该客户端期望拥有的类别比例。若客户端需要固定的 $n_k$ 个样本,可以再决定各类别的整数数量。
难点在于:所有客户端的需求加在一起,可能超过某个类别的实际样本库存。如果独立地从类别池抽样,需要明确是否允许重复;如果不允许重复,需要处理供需不匹配。均衡客户端样本量的实现还可能额外引入约束。
方向二:给每个类别生成客户端比例
对每个类别 $c$,采样一个 $K$ 维向量:
这样每个类别的现有样本都能被分配出去,且 $\sum_kN_{kc}=N_c$。客户端最终的数据量为 $n_k=\sum_cN_{kc}$;对于非空客户端,其经验标签比例为
注意,$r_{c,k}$ 描述的是“类别 $c$ 的样本分给客户端 $k$ 的比例”,不是“客户端 $k$ 中类别 $c$ 的比例”。二者的归一化方向不同。
下面采用第二种构造。它保留整个数据集的类别数量,但不保证客户端样本量相等,也不保证每个客户端都有样本。小 $\alpha$ 时,一个客户端可能拿到多个类别,也可能什么都没有,不能照搬第一种构造中的“一客户端一类别”直觉。
一个可复现的 NumPy 实现
下面的函数接受一维整数标签,返回各客户端拥有的原始样本索引。它先打乱每个类别的索引,用 Dirichlet 生成比例,再通过多项分布决定整数样本数。
| |
这里不会直接把浮点比例乘以 $N_c$ 后向下取整,所以不会出现“每类少分了几个样本”的遗漏;多项分布的计数之和恰好等于 $N_c$。4
空数组是合法的划分结果,但不能直接交给要求非空数据集的训练流程。实验如果不允许空客户端,可以重新设计分配约束,或者使用有次数上限的重采样;应明确报告这些额外规则,而不是悄悄丢弃客户端。
图中的标签热力图使用同一函数生成:20 个客户端、10 个类别,每类 500 个样本,随机种子为 42。颜色表示一个非空客户端内的类别比例,各面板使用相同的色度范围。
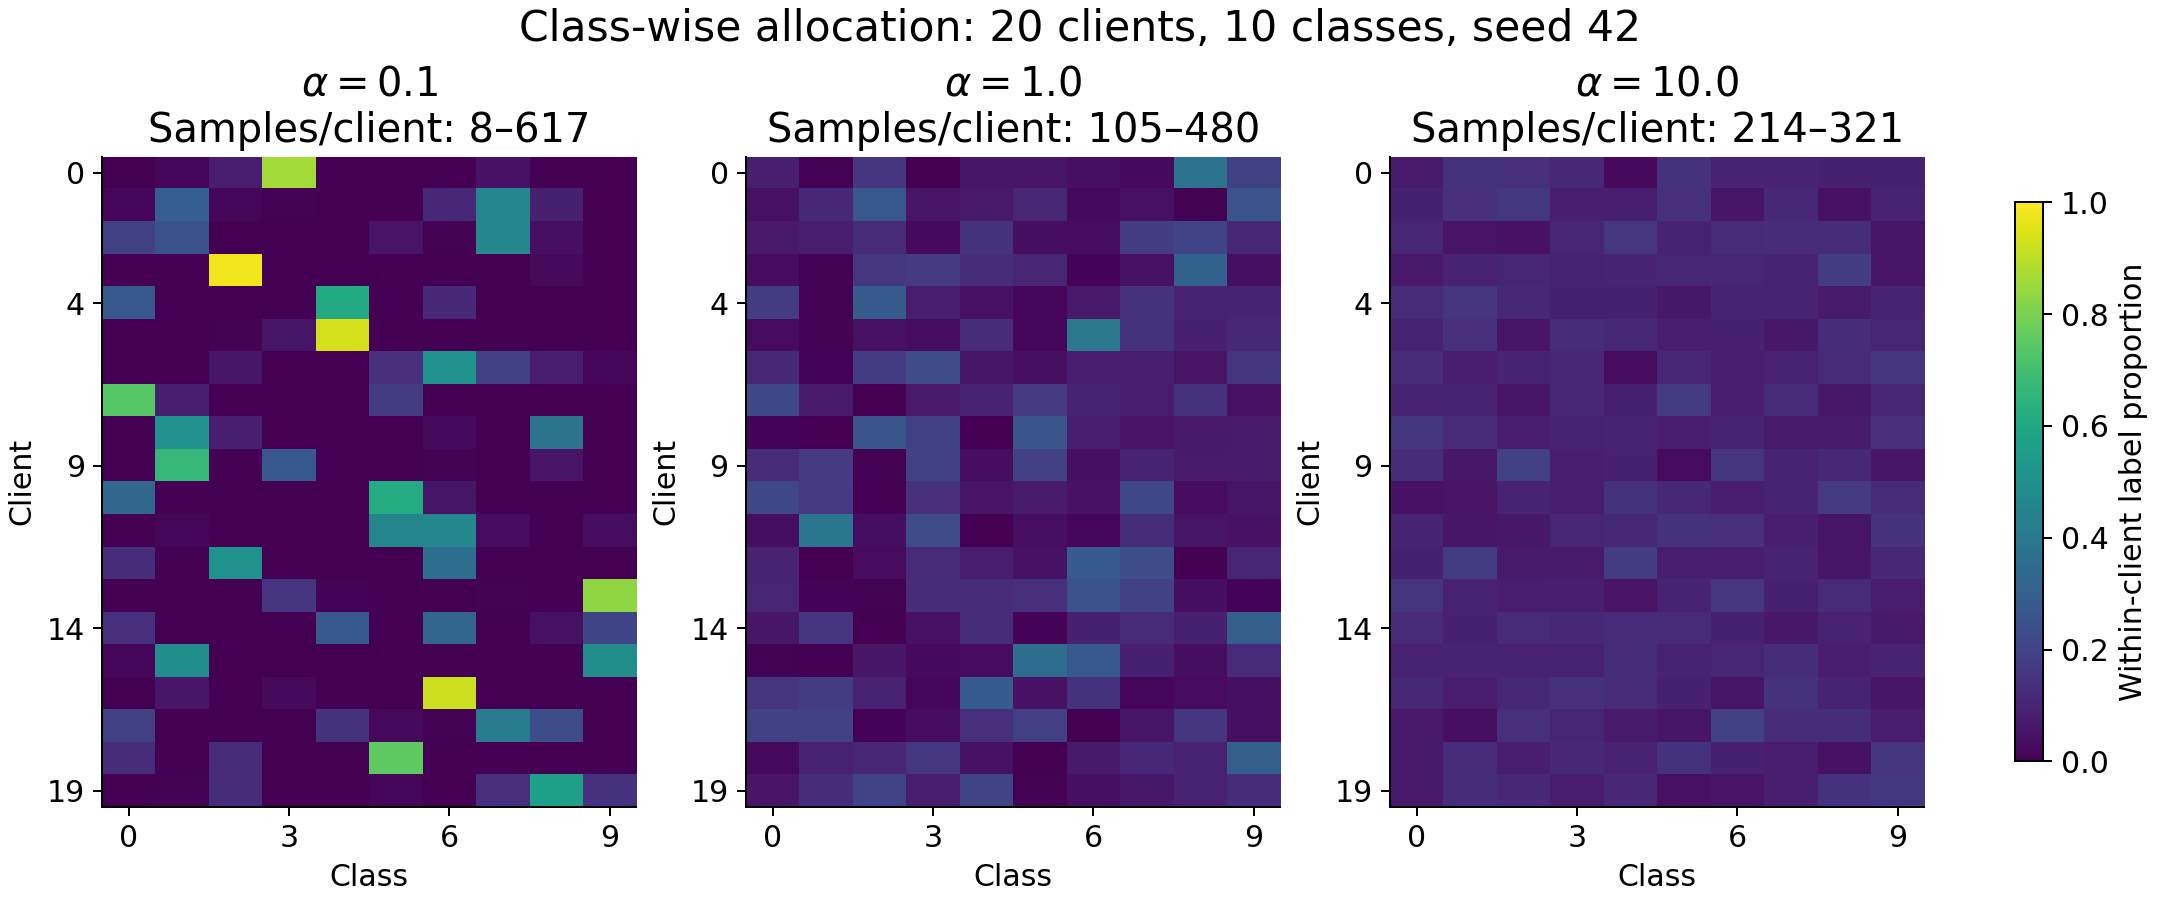
按类别向客户端分配后,较小的 alpha 通常带来更强的标签偏斜,同时也可能改变各客户端的样本量。空客户端若出现则用灰色表示。
做实验时,还需要检查什么?
不要只保存随机种子
记录随机种子很有用,但还应保存最终的客户端索引列表,以及数据集版本、样本顺序和 NumPy 版本。改变数据加载顺序或随机数调用顺序,可能让同一个种子对应完全不同的划分。
如果在同一设置下比较多个算法,尽量复用同一份划分,并使用多个划分种子报告均值与波动。不要把一个偶然容易的划分当成算法优势。
分开观察标签偏斜与样本量偏斜
除了热力图,还应统计每个客户端的样本量、非空类别数,以及标签熵。对于非空客户端,标签熵可以写成
这里使用自然对数,均匀覆盖 $C$ 个类别时为 $\log C$。熵低说明标签更集中,但不能完整描述两个客户端之间的差异:两个客户端都只有一个类别时,熵同为 0,类别却可能完全不同。
按样本量加权的准确率与按客户端平均的准确率也回答不同的问题。前者更偏向整体样本表现,后者更关注一个平均客户端的体验;当 $n_k$ 差异很大时,二者可能相差明显。
小心训练、验证与测试的关系
可以只对训练集进行人工划分,并保留独立、固定的全局测试集;如果要评估客户端本地性能,则需要明确本地测试数据的生成方式。真实多用户数据还应按用户或主体划分,避免同一人的高度相关样本跨训练与测试集合。
在预先固定的客户端归属内划分训练与验证数据,和先对全部样本随机划分后再生成客户端,得到的评价对象可能不同。两种方案都应解释清楚。
比较实验需要报告完整配置
至少记录划分方向、参数向量的定义、$K$、$C$、各类样本量、种子、整数分配方法、空客户端处理、最小样本量约束,以及客户端采样和聚合权重。仅报告“$\alpha=0.5$”不足以让别人重现你的实验。
结语
Dirichlet 分布的作用,是提供一个可以调节波动程度的概率向量。它让我们更方便地构造标签异质性,但 $\alpha$ 并不是脱离维度、分配方向和附加约束之后仍然通用的难度刻度。
真正值得检查的,是最后得到的客户端数据:哪些类别去了哪里,每个客户端有多少样本,评价指标又在衡量谁的表现。把这些细节写清楚,比只在实验表格里放一个 Non-IID 参数更重要。
参考资料与相关阅读
Sources: 5.
Hsu、Qi 与 Brown:Measuring the Effects of Non-Identical Data Distribution for Federated Visual Classification。 ↩︎
Stanford:Modelling Mixtures — the Dirichlet distribution。 ↩︎
NumPy:Generator.dirichlet 与 Generator.multinomial。 ↩︎
NumPy:Generator.dirichlet 与 Generator.multinomial。 ↩︎
深度学习中的隐私泄露:数据留在客户端,并不代表发送的更新不包含敏感信息。 ↩︎

