前言
翻联邦学习的实验部分,经常看到一句话就把划分交代完了,用 Dirichlet 分布,再用 $\alpha$ 调 Non-IID 的程度。第一眼好记,$\alpha$ 越小就越偏。等真要照着分数据,我觉得麻烦反而在那句话省掉的地方。
我会先问,这串比例是某台客户端拿到的各类比例,还是某一类分给各台的比例?再去看 $\alpha$ 是填在每个坐标上的那个数,还是把所有坐标加起来的数。对了,分完以后每台样本数是不是也一起变了?这几件事都会影响实验结果。
所以我想把分数据的过程从头走一遍,后面放个能跑的例子,分完还可以数一数。这里拿标签比例来构造异质性,碰到真实的联邦数据,还会有下面提到的其他差别。
为什么需要模拟 Non-IID?
先想一台具体的客户端。第 $k$ 台的数据来自 $P_k(X,Y)$。如果换一台,数据的来路也变了,那它们各自在最小化的函数就有可能不一样。
把各台的目标合起来,用 $\pi_k\ge0$ 且 $\sum_k\pi_k=1$ 的权重,平时比较常见的是按样本数来加权。开始的时候大家都拿到同一个模型,各自用自己的数据走上几步,再回来看更新,方向可能已经不一样了。
说到 Non-IID,我习惯先拿几个小例子对一下,看看说的到底是哪一种差别。
| 差异 | 一个直观例子 | 仅按标签划分能否完整模拟? |
|---|---|---|
| 标签分布差异 $P_k(Y)$ | 不同设备上猫与狗的图片比例不同 | 可以构造这一维度的差异 |
| 条件特征分布差异 $P_k(X\mid Y)$ | 同样是狗,不同设备使用不同相机拍摄 | 不能完整模拟 |
| 条件标签机制差异 $P_k(Y\mid X)$ | 不同机构对相似样本采用不同标注规则 | 不能完整模拟 |
| 样本量差异 $n_k$ | 活跃用户与低频用户的数据量不同 | 可能被划分过程同时引入 |
这里还有个容易漏的地方。类内样本池即使一直没变,只把各类的比例换一换,各台看到的整体特征也可能跟着变。写实验时,我会把实际动了哪一部分说出来。
要找个例子对照,可以看 Hsu 等人用 Dirichlet 分布改变客户端标签比例、再跑 FedAvg 的那篇。读到他们给的参数,我会先回到划分的那一步,看看这个数用在哪里。1
Dirichlet 分布是什么?
它生成一个概率向量
先看抽一次到底拿到什么。我们手里会多一个 $d$ 维向量,每项加起来正好是 1。
每个参数都满足 $\alpha_i>0$。抽出来那一串是打算各分几成,之后分到第几类、具体有几个样本,是下一步按这些比例去做。
要对着密度算的时候,先把参数加起来,记作 $\alpha_0=\sum_i\alpha_i$。在单纯形内部,密度写成下面这样。
如果看到密度少写了一维,那是因为最后一个比例已经能从前面几个算出来,所以这里用 $d-1$ 维坐标。只有两项,就是 Beta 分布。三个比例的话,索性把每次抽到的结果在三角形里画一个点。
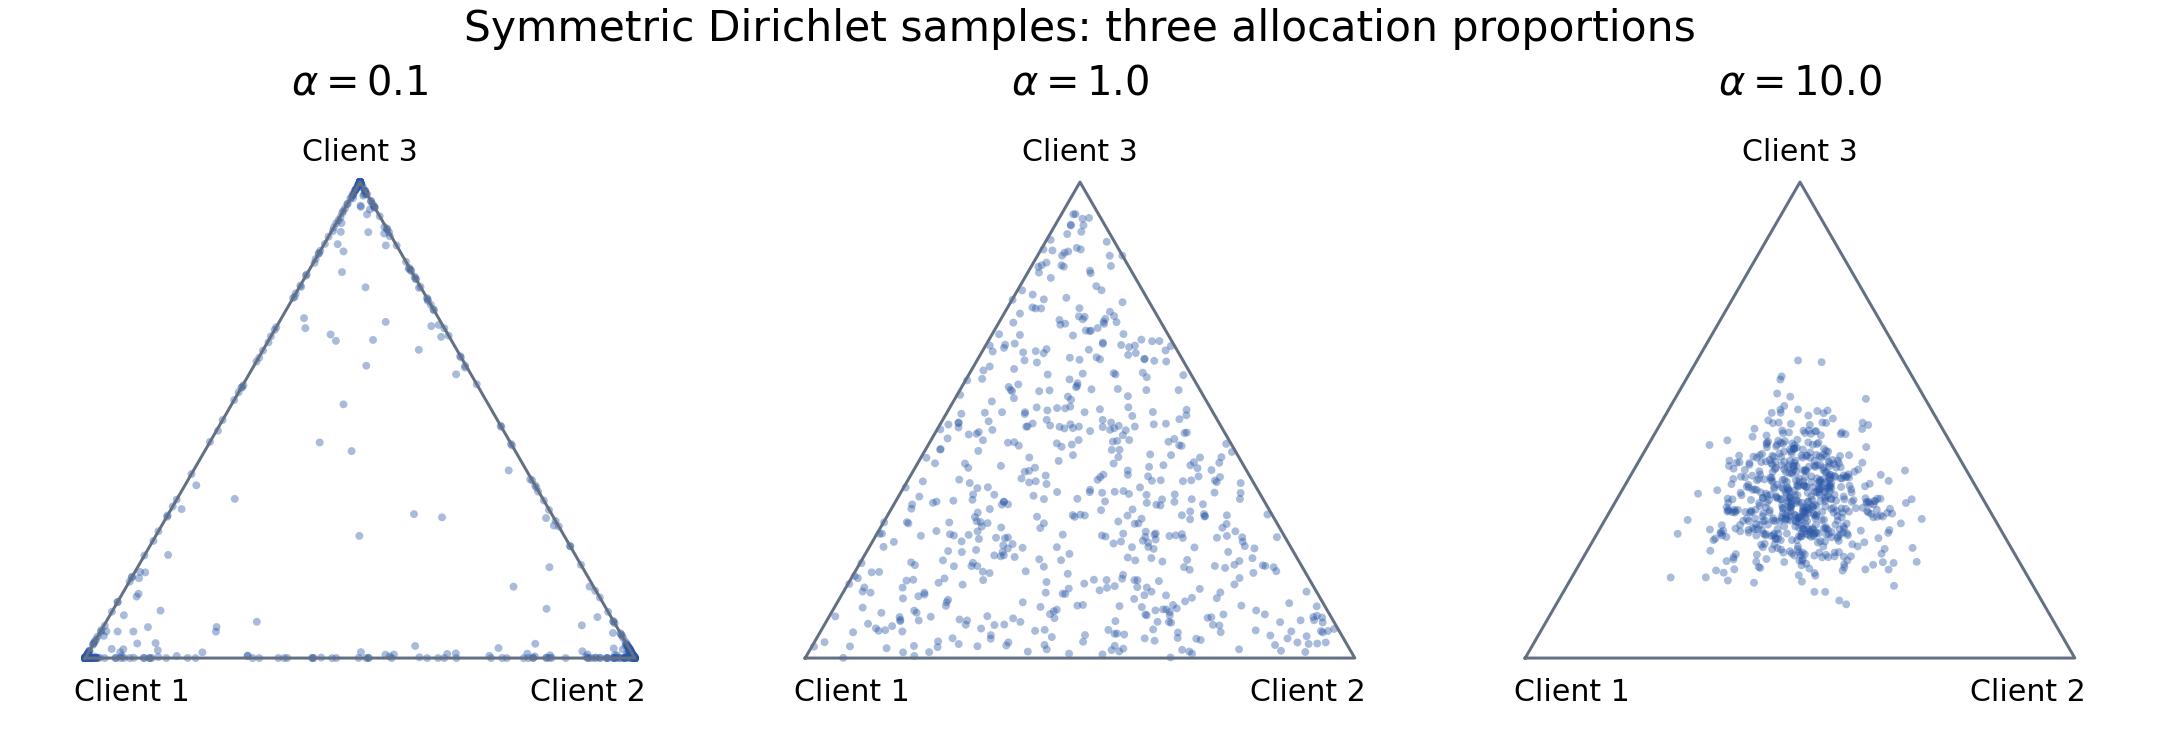
每个点是一组总和为 1 的比例。靠近顶点表示某个分量占主导,靠近中心表示三个分量比较接近。
图里标的 $\alpha$ 是每一个坐标上填的参数。想查密度或采样的细节,我把 Stanford 课程笔记2 和 NumPy 文档3 放在这里。
均值与波动是两件事
图看完,我最想知道的是这些点绕着哪儿散开,又散得多远。可以先把均值、方差和不同坐标之间的协方差写出来。
协方差那个负号,可以用总和来记。手上的比例加起来就这么多,其中一份往上走,其他份加起来就得往下走。
再把参数取得简单一点,每个坐标都填同一个数,也就是 $\alpha_1=\cdots=\alpha_d=\alpha$,这时几个式子会好读一些。
原来「$\alpha$ 小就更偏」,说的是单次抽到的结果更容易离均值远。你连抽两次试想一下,第一回可能几乎全给了第一项,第二回又可能几乎全给第三项。按分布去算,每一项的期望还是一样。
- $\alpha<1$ 时,对着上面三个坐标的图看,点更容易贴着三角形的边和角,有些分量很小,也会有一项占得特别多。
- $\alpha=1$ 时,是在单纯形里均匀取点。你可以想象点落在里面各处,当然也会有落到边上附近、比例差很多的。
- $\alpha>1$ 时,点更往里聚。$\alpha$ 再大一些,每项就更靠近 $1/d$。
这个趋势要多画些点才明显。单看两次抽样,小 $\alpha$ 也可能刚好落到中间,大 $\alpha$ 也有离开中间的时候。另外,比例差不多以后还得分整数个样本。就算用了大的 $\alpha$,最终落到各台的经验分布也还有取样波动。
单个坐标参数与总浓度
如果想先决定这些点绕着哪里,再决定散开多少,可以把参数换个写法,取 $\alpha_i=s m_i$,其中 $m_i>0$ 且 $\sum_i m_i=1$。
这样读的时候,我会先看 $\mathbf m$ 给的中心,再看 $s$ 压住了多少波动。假如希望中心几项一样大,就取 $m_i=1/d$,每一项的参数也就跟着成了 $s/d$。
这就是我看到两篇论文都写 alpha 时,会多去翻一眼定义的原因。$\operatorname{Dir}(\alpha,\ldots,\alpha)$ 这组参数加起来是 $d\alpha$,$\operatorname{Dir}(\alpha\mathbf m)$ 的总浓度则是 $\alpha$。Hsu 等人用的是后一种写法,想照着跑的时候,最好也记下自己用的是哪一种。
在联邦学习中,有两种划分方向
设共有 $K$ 个客户端、$C$ 个类别,类别 $c$ 的样本量为 $N_c$。
方向一:给每个客户端生成类别比例
第一种可以先坐到客户端 $k$ 那边看。它抽到一串 $C$ 维比例,每一项说的是希望这个客户端里有多少相应的类别。
要是这台得拿到固定的 $n_k$ 个样本,再用手里那串比例去定每个类别具体要几个。
做到这儿再把所有人的单子加起来,可能发现某一类被要走的数已经超过库存。分别从类别池里抽时,得说清能不能重复用同一个样本。要是每个样本只分一次,就要处理这里的供需差。若还想让各台一样大,也要把这个约束一起放进来。
方向二:给每个类别生成客户端比例
也可以把顺序反过来。先拿出类别 $c$ 的全部样本,想的是把这堆分给谁。这时抽的比例有 $K$ 项,对应各台客户端。
这么分,每类的库存都能用完,$\sum_kN_{kc}=N_c$。各台最后拿到多少,要等分完所有类别再加出来,记 $n_k=\sum_cN_{kc}$。有样本的那台,就可以再数它里面每类占几成。
$r_{c,k}$ 我会用一句话记。手里抓着的是类别 $c$ 的那堆样本,问其中有几成送到客户端 $k$。要回头问客户端 $k$ 里类别 $c$ 占几成,就得把分母换成这台的数据量。
下面就用第二种,一类一类分,最后看看各台都剩下了什么。类别的总数能对上,各台的数据量则要分完才知道。小 $\alpha$ 时也可能一台一下拿走了好几类,另一台还是空的。
一个可复现的 NumPy 实现
下面这个函数可以跟着刚才的顺序读。输入是一维的整数标签。每次取出同一类别,把它的索引打乱,抽一串 Dirichlet 比例,再用多项分布把比例变成整数样本数。最后返回的是原数据里的索引。
| |
这里我会特意数一下有没有漏样本。直接拿比例乘 $N_c$、每项往下取整,很容易有几个没分出去。用多项分布时,把得到的各项加回来正好是 $N_c$。4
要是跑出来某一台是空数组,先别着急把它扔了。它是在按这套规则分数据时可能出现的情况。训练流程要每台非空的话,可以明确加个分配约束,或者限定重抽的次数。用了哪条规则,记在实验设置里。
可以对着图看一次结果。我这里用上面同一个函数,20 台客户端、10 类数据,每类 500 个样本,种子取 42。颜色看的是非空客户端里每类占多少,几张图都用同一段颜色范围。
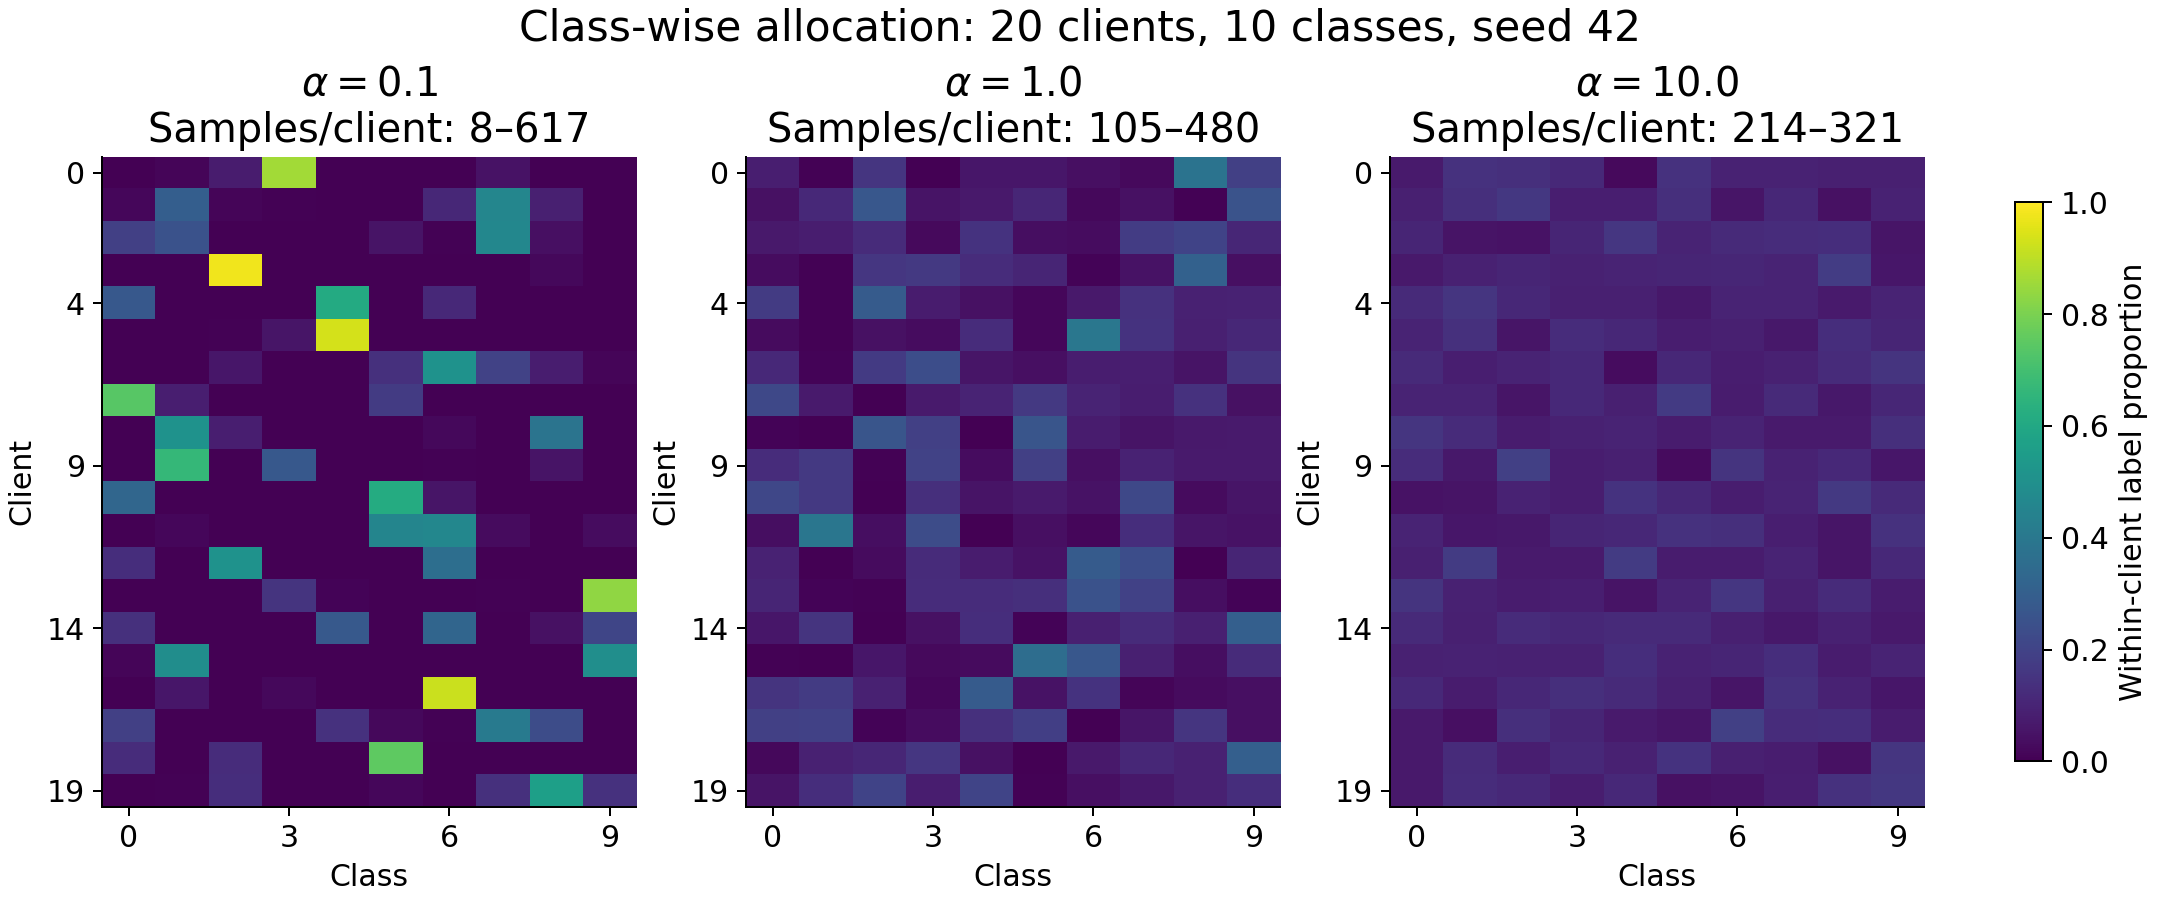
按类别向客户端分配后,较小的 alpha 通常带来更强的标签偏斜,同时也可能改变各客户端的样本量。空客户端若出现则用灰色表示。
做实验时,还需要检查什么?
不要只保存随机种子
如果想下次还能跑出这份划分,我会把真正分到各台的索引也存下来。种子当然也记上,还有数据集和 NumPy 的版本、样本原来的顺序。哪怕种子一样,换了加载顺序,或者前面多调用了一次随机数,也可能分出另一份。
要是这份数据拿来比几个算法,我会先让大家用同一份划分。然后换几次划分种子,看看均值和波动,免得刚好抽到的一次比较容易就被当成算法本身的效果。
分开观察标签偏斜与样本量偏斜
我一般会在看完热力图之后,顺手数一下各台有几个样本、有几类和标签熵。有数据的客户端,标签熵可以按下面这个式子算。
这里用自然对数,$C$ 个类别分得均匀时是 $\log C$。数小了,表示标签更集中。你可以想两台各拿了一类,一台只拿猫、另一台只拿狗,熵都是 0,看到的标签却完全不同。
报准确率时,还有件事我会顺带问一下。把每个样本一样看重,和把每台客户端一样看重,平均出来的意思不同。$n_k$ 差很大时,最好知道你要讲的是整体样本表现,还是一台普通客户端的表现。
小心训练、验证与测试的关系
可以先留一份独立的全局测试集,把它定住,只动训练集的划分。想看每台客户端自己的表现,就得顺带交代每台的测试数据怎么来。遇到真实的多用户数据,我会按用户或主体切,省得同一个人的相近样本在训练和测试里各放一份。
有时先分好客户端,再在各台里面切训练和验证。有时先把整份数据切了,再去分客户端。顺序换了,最后评价的对象也可能会变。我会把自己用了哪种顺序写出来。
比较实验需要报告完整配置
如果有人只发给我一个 $\alpha=0.5$,我还得回去问一串问题。顺着哪边划分,参数是怎么填的,$K$ 和 $C$ 各是多少,每类有几个样本?种子、整数分法、空客户端和最小样本数也要记上,最后再说明怎么选客户端、怎么给聚合加权。
结语
写完再看到 Dirichlet,我会先想到手里抽的是一串比例,那个参数能调它围着平均值散得多远。至于 $\alpha$ 取多大才算难,要回到分了几维、往哪个方向分,还有代码里加过哪些限制。
最后我还是会把分完的索引翻出来看。每类去了哪,各台有多少样本,报那个指标的时候又把谁平均进来了。下次要和别人的实验对,我想拿这几个数一起看。
参考资料与相关阅读
Sources: 5.
Hsu、Qi 与 Brown:Measuring the Effects of Non-Identical Data Distribution for Federated Visual Classification。 ↩︎
Stanford:Modelling Mixtures — the Dirichlet distribution。 ↩︎
NumPy:Generator.dirichlet 与 Generator.multinomial。 ↩︎
NumPy:Generator.dirichlet 与 Generator.multinomial。 ↩︎
深度学习中的隐私泄露:数据留在客户端,并不代表发送的更新不包含敏感信息。 ↩︎